SLM ou LLM ? Ce que propose NVIDIA pour l’IA agentique, et comment choisir selon la tâche, la latence, le coût et les données, avec une cascade de modèles.
SLM ou LLM en production : le point de vue de NVIDIA
Le débat entre SLM et LLM est souvent mal posé. Il est fréquemment résumé à une opposition trop simple : les grands modèles seraient plus intelligents, les petits seraient plus rapides.
Cette lecture est insuffisante pour prendre une décision d'architecture. Dans une application réelle, le choix d'un modèle de langage est un arbitrage entre qualité, coût, latence, gouvernance des données et complexité d'exploitation.
La vraie question n'est donc pas : quel modèle est le plus impressionnant ? La vraie question est : quel modèle est suffisant pour le problème à résoudre ?
La position de NVIDIA : des SLM pour l'IA agentique
En juin 2025, une équipe de NVIDIA Research a publié l'article Small Language Models are the Future of Agentic AI. Sa thèse est simple : dans un système agentique, la plupart des appels au modèle sont des tâches répétitives et étroites (choisir un outil, extraire un paramètre, formater une sortie). Pour ces appels, un petit modèle est souvent suffisant, moins cher à exécuter et plus facile à spécialiser ; les grands modèles devraient être réservés aux étapes qui exigent un raisonnement ouvert.
Les auteurs proposent aussi une démarche de migration : journaliser les appels d'un agent existant, regrouper les tâches récurrentes, puis remplacer progressivement les appels concernés par des petits modèles spécialisés. Cette position est un argument d'architecture et d'économie, pas une loi universelle : elle doit être vérifiée sur vos propres tâches.
Que recouvrent vraiment SLM et LLM
Les termes varient selon les acteurs, et la frontière de taille bouge à chaque génération. L'idée générale reste stable.
SLM
Un Small Language Model est un modèle compact, de quelques centaines de millions à une dizaine de milliards de paramètres. Les familles Phi (Microsoft), Gemma (Google), Llama dans ses petites variantes (Meta), Qwen ou Mistral en proposent des versions exécutables sur un GPU unique, voire sur un poste de travail. Il est souvent adapté à :
- des usages ciblés ;
- des environnements contraints ;
- une inférence locale ou en périphérie (edge) ;
- des flux à faible latence.
LLM
Un Large Language Model vise des capacités plus générales :
- une couverture de connaissances plus large ;
- une meilleure capacité de raisonnement sur des tâches ouvertes ;
- plus de souplesse sur des demandes très variées.
En contrepartie, il implique souvent plus de coût, plus de latence, plus de consommation GPU ou d'API, et un fournisseur externe lorsqu'il n'est pas auto-hébergeable.
Ce qu'un architecte doit regarder en premier
1. La nature exacte de la tâche
Exemples où un SLM peut suffire :
- classification de tickets ;
- extraction de champs ;
- routage de demandes ;
- reformulation simple ;
- étiquetage de contenu ;
- choix d'un outil parmi une liste courte.
Exemples où un LLM peut être plus pertinent :
- synthèse longue et nuancée ;
- génération de contenu ouvert ;
- raisonnement en plusieurs étapes ;
- appel d'outils complexe avec planification ;
- analyse sur un contexte riche et hétérogène.
Si le problème est étroit et bien borné, un SLM peut offrir un meilleur rapport valeur/coût.
2. La latence acceptable
Dans un workflow interactif, la latence change complètement l'expérience. Un assistant interne peut tolérer quelques secondes ; une complétion de code, beaucoup moins ; un routage automatique dans une API temps réel, encore moins.
Les petits modèles sont souvent plus intéressants quand la réponse doit être quasi immédiate, quand le volume de requêtes est élevé ou quand le coût unitaire doit rester très bas.
3. Le coût d'exploitation
Le coût ne se limite pas au prix d'API ou au besoin GPU. Il faut prendre en compte le trafic moyen, les pics de charge, la longueur du contexte, le nombre d'appels par workflow, le taux de nouvelles tentatives et l'éventuelle supervision humaine.
Un modèle trop gros pour le besoin peut rendre un cas d'usage non rentable, même s'il fonctionne bien techniquement. À l'inverse, un SLM auto-hébergé a un coût fixe (GPU, exploitation, mises à jour) qui ne se justifie qu'au-delà d'un certain volume.
4. La gouvernance des données
Si les données sont sensibles ou si l'environnement impose des contraintes fortes, les SLM prennent parfois un avantage important, surtout lorsqu'ils peuvent tourner localement ou dans un périmètre maîtrisé. Le choix de modèle devient alors aussi un sujet de conformité, de localisation des données, d'auditabilité et de maîtrise du risque fournisseur.
Le piège du benchmark générique
Comparer SLM et LLM sur des benchmarks publics est utile, mais insuffisant. Ces scores ne disent pas :
- si le modèle est bon sur vos données ;
- s'il respecte votre format de sortie ;
- s'il tient la charge ;
- s'il reste stable dans votre workflow ;
- s'il est économiquement tenable.
Un modèle moyen sur un benchmark peut être excellent dans un cas d'usage étroit. À l'inverse, un modèle de premier plan peut être inutilement cher pour une tâche répétitive et simple.
Une stratégie souvent plus efficace : la cascade de modèles
Dans beaucoup de systèmes, il n'est pas nécessaire de choisir un seul modèle pour tout. Une architecture plus mature utilise un SLM pour le tri, la classification ou le prétraitement, et un LLM pour les cas complexes ou ambigus.
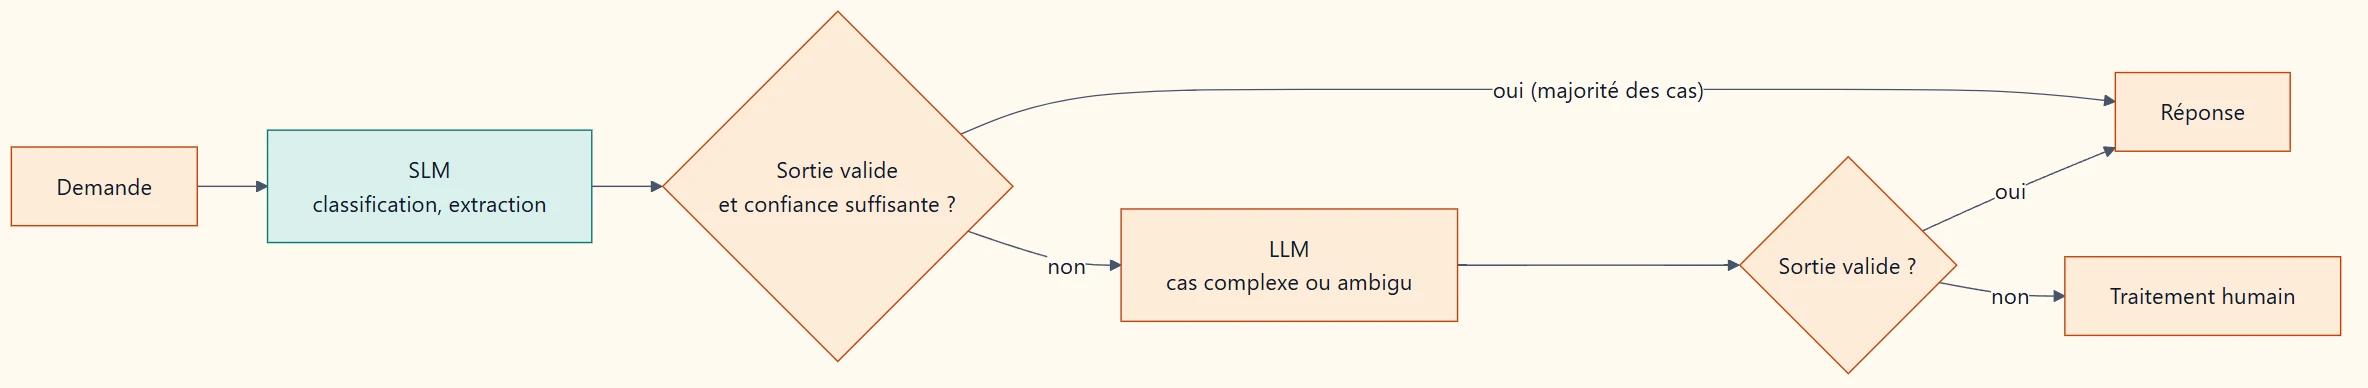
La condition de bascule doit être vérifiable : sortie conforme au schéma attendu, valeur dans une liste autorisée, score de confiance fourni par un classifieur. Ne demandez pas au petit modèle d'auto-évaluer librement sa réponse. En .NET, cette cascade se construit avec des clients IChatClient composés, comme le montre résilience IA .NET : routage et failover testés.
Les SLM ne sont pas seulement de « petits LLM »
Une erreur fréquente consiste à voir les SLM comme une version dégradée des grands modèles. Un petit modèle bien choisi peut être meilleur sur un usage ciblé s'il a été spécialisé (par affinage ou par distillation), s'il tourne plus près des données, s'il offre une latence beaucoup plus faible ou si son comportement est plus stable dans un cadre étroit.
En pratique, beaucoup de workflows applicatifs n'ont pas besoin d'un raisonnement ouvert. Ils ont besoin d'une sortie propre, rapide et prévisible.
Quand un LLM reste le bon choix
Les grands modèles gardent un avantage net pour les conversations ouvertes avec contexte riche, les synthèses complexes, la génération sous de multiples contraintes, le raisonnement en plusieurs étapes et l'orchestration d'outils élaborée.
Ils sont aussi utiles quand le coût d'une erreur est plus élevé que le coût d'inférence : assistance à l'analyse technique, support expert ou exploration documentaire avancée. Payer plus cher pour une meilleure capacité est alors une décision rationnelle. Les modèles de pointe récents, comme GPT-6 Astra, ciblent précisément ces tâches longues et difficiles.
Les questions à poser avant de choisir
- Quel est le niveau minimal de qualité nécessaire ?
- Quelle latence maximale est acceptable ?
- Quel budget par requête est soutenable ?
- Les données peuvent-elles sortir du périmètre contrôlé ?
- La tâche est-elle générale ou très contrainte ?
- Faut-il privilégier la rapidité, la finesse ou la robustesse ?
Ces questions donnent une base de décision beaucoup plus utile qu'une simple comparaison de taille de modèle.
Évaluer sur votre propre workflow
Le choix doit être validé par une évaluation sur des exemples proches de la production. Testez la qualité de sortie, la régularité, le taux d'erreur, la latence, le coût et la facilité d'intégration. Une évaluation minimale avec un jeu de cas représentatifs vaut plus qu'un long débat théorique ; sa mise en place en .NET est détaillée dans les tests d'évaluation IA .NET.
Une grille de décision simple
- Tâche simple, répétitive, structurée : commencer par un SLM.
- Tâche ambiguë, riche en contexte, exigeante : envisager un LLM.
- Volume très élevé : privilégier un SLM ou une cascade.
- Criticité forte : évaluer les deux sur des jeux de cas réels.
Cette approche limite les choix idéologiques. Pour se former aux fondamentaux qui permettent de mener ces évaluations, voir les cours gratuits Google sur l’IA.
Conclusion
Le choix entre SLM et LLM n'est pas un débat abstrait sur la puissance des modèles. C'est un sujet de conception applicative et de compromis d'exploitation.
Un bon système n'utilise pas le modèle le plus grand possible. Il utilise le modèle le plus adapté à la tâche, au niveau de service attendu et aux contraintes du produit. Pour l'intégration elle-même, voir intégrer un LLM dans une application .NET avec IChatClient.
Source
- Peter Belcak et al., NVIDIA Research, Small Language Models are the Future of Agentic AI, 2025.