Un inventaire Ansible introuvable peut laisser votre workflow au vert sans rien déployer. Reproduisez ce piège et bloquez les faux succès dans votre CI/CD.
Ansible : workflow vert malgré un inventaire introuvable
Le workflow est vert. Le job de déploiement est marqué comme réussi. Pourtant, en relisant les logs, on découvre un inventaire introuvable et cette ligne : skipping: no hosts matched.
Comment une automatisation peut-elle réussir alors qu’elle n’a rien déployé ? Avec Ansible, une absence de cibles peut être traitée comme un avertissement, puis comme un play ignoré, sans provoquer de code de sortie non nul. La CI affiche alors le statut que lui transmet le processus.
Ce comportement ne signifie pas qu’Ansible ignore toutes les erreurs. Une tâche qui échoue sans gestion particulière fait normalement échouer l’exécution. Le piège présenté ici intervient en amont : aucune machine n’est sélectionnée, donc aucune tâche n’a l’occasion d’échouer.
Ansible, inventaire et playbook : qui décide quoi ?
Ansible automatise la configuration de machines et le déploiement d’applications. Un inventaire décrit les hôtes et leurs groupes ; un playbook décrit les opérations à exécuter. La propriété hosts sélectionne les cibles dans cet inventaire.
Pour une API ASP.NET Core, on pourrait avoir un groupe web contenant les serveurs applicatifs et un playbook chargé de copier un artefact, de redémarrer un service puis de vérifier sa disponibilité. Si cet artefact est une image de conteneur, il peut être produit directement par le SDK, comme expliqué dans créer une image .NET sans Dockerfile.
Trois questions différentes doivent être posées :
- L’inventaire demandé a-t-il été chargé correctement ?
- Le motif d’hôtes sélectionne-t-il les machines attendues ?
- Les opérations prévues ont-elles abouti sur ces machines ?
Un code de sortie 0 ne prouve pas, à lui seul, que ces trois conditions sont réunies.
Reproduire le workflow vert avec un inventaire absent
L’exemple suivant a été vérifié avec Ansible Core 2.18.6, Python 3.12 et Bash, sur un contrôleur Linux. Cette version fixe le contexte de reproduction ; elle n’est pas une recommandation de version pour la production. Les avertissements exacts peuvent varier selon les versions et les plugins d’inventaire.
Dans un dossier de démonstration, créez un fichier ansible.cfg vide pour utiliser les valeurs par défaut :
touch ansible.cfg
export ANSIBLE_CONFIG="$PWD/ansible.cfg"
ansible-playbook --version
Puis créez deploy.yml :
---
- name: Démontrer la sélection des serveurs
  hosts: web
  gather_facts: false
  tasks:
    - name: Confirmer que la tâche est exécutée
      ansible.builtin.debug:
        msg: "La tâche de déploiement est exécutée"
Appelez volontairement un inventaire qui n’existe pas. Dans ce test, utilisez un terminal sans set -e pour pouvoir afficher le statut après la commande :
ansible-playbook -i inventaire-absent.ini deploy.yml
rc=$?
printf 'Code de sortie : %s\n' "$rc"
Voici les lignes utiles du journal, abrégées et avec les chemins simplifiés :
[WARNING]: Unable to parse .../inventaire-absent.ini as an inventory source
[WARNING]: No inventory was parsed, only implicit localhost is available
[WARNING]: Could not match supplied host pattern, ignoring: web

PLAY [Démontrer la sélection des serveurs]
skipping: no hosts matched

PLAY RECAP

Code de sortie : 0
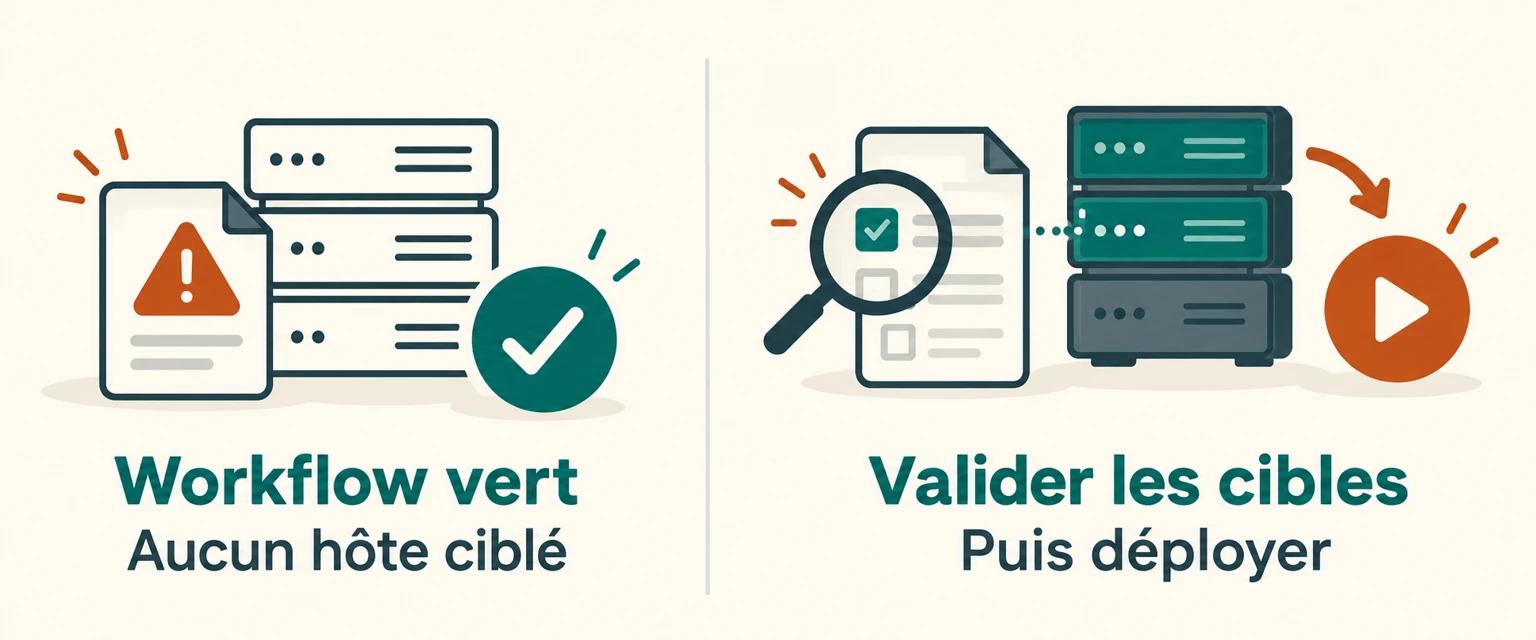
Le message de la tâche debug n’apparaît pas : elle n’a jamais été exécutée. Dans un workflow qui se fonde sur le code de sortie, cette commande peut pourtant être considérée comme réussie.
Le localhost implicite mentionné dans le journal ne remplace pas vos serveurs. Il ne fait notamment pas partie du groupe all par défaut. Un play qui cible explicitement localhost peut, lui, exécuter des actions locales : l’inventaire absent ne garantit donc pas que toute l’exécution soit sans effet.
Pourquoi Ansible ne renvoie-t-il pas une erreur ?
Par défaut, l’impossibilité de charger toutes les sources d’inventaire déclenche un avertissement. Un motif d’hôtes inconnu est également signalé par un avertissement. Ansible peut poursuivre, puis ignorer un play sans cible.
La référence de configuration Ansible expose les options permettant de rendre ces situations bloquantes.
Dans une CI/CD, le contrat attendu est souvent plus strict : « déployer sur les serveurs de cet environnement ». Dans ce contexte, zéro serveur devrait faire échouer le job. Il faut exprimer cette règle explicitement.
Première protection : rendre le chargement de l’inventaire strict
Pour une exécution de déploiement où chaque source fournie doit être exploitable, utilisez ce ansible.cfg :
[inventory]
unparsed_is_failed = true
any_unparsed_is_failed = true
host_pattern_mismatch = error
Ces réglages couvrent des situations différentes :
| Option | Situation bloquée |
|---|---|
unparsed_is_failed | Aucune des sources d’inventaire n’a pu être chargée |
any_unparsed_is_failed | Au moins une source fournie n’a pu être chargée, même si une autre fonctionne |
host_pattern_mismatch | Un motif d’hôtes ne correspond à aucun hôte ou groupe connu |
Avec plusieurs sources, le deuxième réglage évite qu’un inventaire partiellement chargé passe inaperçu. Adaptez-le à votre organisation si certaines sources sont volontairement optionnelles.
La même intention peut être déclarée dans l’environnement du job :
export ANSIBLE_INVENTORY_UNPARSED_FAILED=true
export ANSIBLE_INVENTORY_ANY_UNPARSED_IS_FAILED=true
export ANSIBLE_HOST_PATTERN_MISMATCH=error
Attention au nom de la première variable : il s’agit de ANSIBLE_INVENTORY_UNPARSED_FAILED, sans IS. Vérifiez les noms supportés par votre version avec ansible-config list.
Assurez-vous aussi que la bonne configuration est chargée :
export ANSIBLE_CONFIG="$PWD/ansible.cfg"
ansible --version
ansible-config dump --only-changed
ansible-playbook -i inventaire-absent.ini deploy.yml
Le test avec l’inventaire absent renvoie maintenant un code non nul. Une variable d’environnement peut remplacer une valeur du fichier : inspecter les valeurs effectives permet de détecter une configuration écrasée par le runner.
Deuxième protection : vérifier les cibles réellement sélectionnées
La configuration stricte ne garantit pas qu’un déploiement ait des cibles. Prenons deux groupes existants, contenant des machines différentes :
[web]
web01 ansible_connection=local

[db]
db01 ansible_connection=local
Le motif web:&db demande les machines appartenant aux deux groupes. Ici, son résultat est vide. Dans le test avec Ansible Core 2.18.6, un play utilisant ce motif a encore été ignoré avec un code 0, malgré les trois réglages stricts.
Ajouter un assert dans les pre_tasks du play de déploiement ne résout pas ce cas : sans hôte sélectionné, ces tâches ne sont pas exécutées non plus.
Une solution est un playbook de contrôle séparé, exécuté sur le contrôleur, avant le playbook de déploiement. Créez preflight.yml :
---
- name: Vérifier les cibles avant le déploiement
  hosts: localhost
  connection: local
  gather_facts: false
  tasks:
    - name: Exiger un motif de ciblage explicite
      ansible.builtin.assert:
        that:
          - target_pattern is defined
        fail_msg: "Le paramètre target_pattern est obligatoire."

    - name: Refuser une sélection vide
      ansible.builtin.assert:
        that:
          - query('ansible.builtin.inventory_hostnames', target_pattern) | length > 0
        fail_msg: "Aucun hôte ne correspond à {{ target_pattern }}."
Le playbook deploy.yml doit utiliser le même motif :
---
- name: Exécuter les opérations sur les cibles validées
  hosts: "{{ target_pattern }}"
  gather_facts: false
  tasks:
    - name: Confirmer les hôtes sélectionnés
      ansible.builtin.debug:
        msg: "Cible validée : {{ inventory_hostname }}"
Puis lancez les deux commandes avec les mêmes paramètres :
set -euo pipefail
inventory="$PWD/inventory.ini"
target_pattern='web'

test -s "$inventory"
ansible-playbook -i "$inventory" preflight.yml \
  -e "target_pattern=$target_pattern"
ansible-playbook -i "$inventory" deploy.yml \
  -e "target_pattern=$target_pattern"
test -s convient ici à un fichier d’inventaire statique : il vérifie son existence et sa taille, pas sa validité. Il ne convient pas à toutes les sources d’inventaire, comme une liste d’hôtes passée directement en ligne de commande.
Cet exemple n’ajoute pas de --limit : la sélection est entièrement portée par target_pattern. Si vous utilisez une limite supplémentaire, le contrôle doit vérifier la sélection finale, limite comprise. N’appliquez pas une limite de serveurs au playbook preflight.yml, sous peine d’exclure son localhost.
Pour un inventaire dynamique, les deux commandes peuvent récupérer deux états différents. Si la cohérence exacte des cibles est nécessaire, matérialisez un instantané d’inventaire réutilisé par les deux exécutions. Et si vous attendez trois serveurs précis, contrôlez leurs identités : une sélection non vide reste une garantie minimale.
Troisième protection : préserver le code de sortie dans la CI
Un autre mécanisme peut masquer une véritable erreur : le shell ou le workflow absorbe le code non nul.
# Sans pipefail, le statut du pipeline peut être celui de tee.
ansible-playbook -i inventory.ini deploy.yml | tee deploy.log

# Cette construction transforme un échec en succès.
ansible-playbook -i inventory.ini deploy.yml || true
En Bash, utilisez :
set -euo pipefail
ansible-playbook -i inventory.ini deploy.yml 2>&1 | tee deploy.log
pipefail conserve l’échec d’Ansible lorsqu’il existe. Il ne change rien au premier piège : si Ansible renvoie lui-même 0 sans cible, la configuration stricte et le contrôle préalable restent nécessaires.
Vérifiez également les options comme continue-on-error dans GitHub Actions et les scripts qui terminent par une commande réussie après avoir ignoré l’échec précédent.
Exemple de job GitHub Actions
Voici le cœur d’un job, à intégrer après le checkout et l’installation de la version Ansible validée par votre équipe. Il suppose que les fichiers précédents sont à la racine du dépôt et que inventory.ini contient des cibles locales de démonstration.
- name: Valider les cibles puis exécuter Ansible
  shell: bash
  env:
    ANSIBLE_INVENTORY_UNPARSED_FAILED: "true"
    ANSIBLE_INVENTORY_ANY_UNPARSED_IS_FAILED: "true"
    ANSIBLE_HOST_PATTERN_MISMATCH: "error"
    TARGET_PATTERN: "web"
  run: |
    set -euo pipefail
    export ANSIBLE_CONFIG="$GITHUB_WORKSPACE/ansible.cfg"
    inventory="$GITHUB_WORKSPACE/inventory.ini"
    test -s "$inventory"
    ansible-config dump --only-changed
    ansible-playbook -i "$inventory" preflight.yml \
      -e "target_pattern=$TARGET_PATTERN"
    ansible-playbook -i "$inventory" deploy.yml \
      -e "target_pattern=$TARGET_PATTERN" 2>&1 | tee deploy.log
Le playbook de démonstration affiche les cibles ; il ne déploie pas une application. Dans votre projet, remplacez cette tâche par vos rôles de déploiement et préparez l’authentification des machines distantes.
Terminez par une vérification du résultat attendu : service actif, endpoint de santé accessible et version déployée conforme à l’artefact. Un endpoint qui répond encore avec l’ancienne version ne prouve pas que le nouveau déploiement a réussi.
Et si une tâche affiche FAILED mais que le job reste vert ?
C’est un diagnostic différent. Inspectez ignore_errors, failed_when: false ou un bloc rescue qui traite l’échec avec succès. Ces mécanismes sont utiles lorsqu’un incident est prévu et récupérable, mais ils changent la signification du statut final.
Un échec critique récupéré uniquement pour journaliser ou nettoyer doit être relancé explicitement, par exemple avec ansible.builtin.fail dans le bloc de récupération. Ne cherchez pas les mots « ERROR » ou « FAILED » avec un simple grep pour décider du statut : leur présence dans un journal ne décrit pas à elle seule le résultat de l’exécution.
Les cas à vérifier avant de faire confiance au vert
| Scénario | Résultat attendu dans un déploiement strict |
|---|---|
| Fichier d’inventaire absent | Échec avant le déploiement |
| Source d’inventaire invalide | Échec de chargement |
| Une source invalide parmi plusieurs | Échec si toutes les sources sont obligatoires |
| Groupe inconnu | Échec de sélection |
| Intersection de groupes vide | Échec du contrôle préalable |
| Cibles valides et tâches réussies | Succès |
| Tâche critique en échec | Échec, y compris avec une sortie envoyée à tee |
| Ancienne version encore servie après le déploiement | Échec de la vérification fonctionnelle |
D’autres retours sur la fiabilité des pipelines sont regroupés dans le parcours DevOps et CI/CD pour .NET, notamment les quality gates d’une application IA .NET, qui appliquent la même logique : un statut vert doit refléter une vérification réelle.
Le critère utile pour une pipeline de déploiement est concret : les bonnes machines ont reçu la bonne version, et cette version fonctionne. Pour qu’un workflow vert ait ce sens, validez le chargement de l’inventaire, contrôlez les cibles, conservez les échecs et vérifiez le résultat final.