Hébergez un workflow .NET dans Microsoft Foundry, reprenez une réponse en arrière-plan après incident et protégez les effets de bord par idempotence.
Reprendre un workflow IA .NET après un redémarrage
Une réponse d’agent peut durer plus longtemps que le processus qui l’héberge : analyse d’un incident, génération d’un rapport ou attente d’une validation. Relancer le processus sans stratégie de reprise laisse alors deux mauvais choix : perdre le travail, ou rejouer aveuglément une opération qui a peut-être déjà créé un ticket ou déclenché un changement.
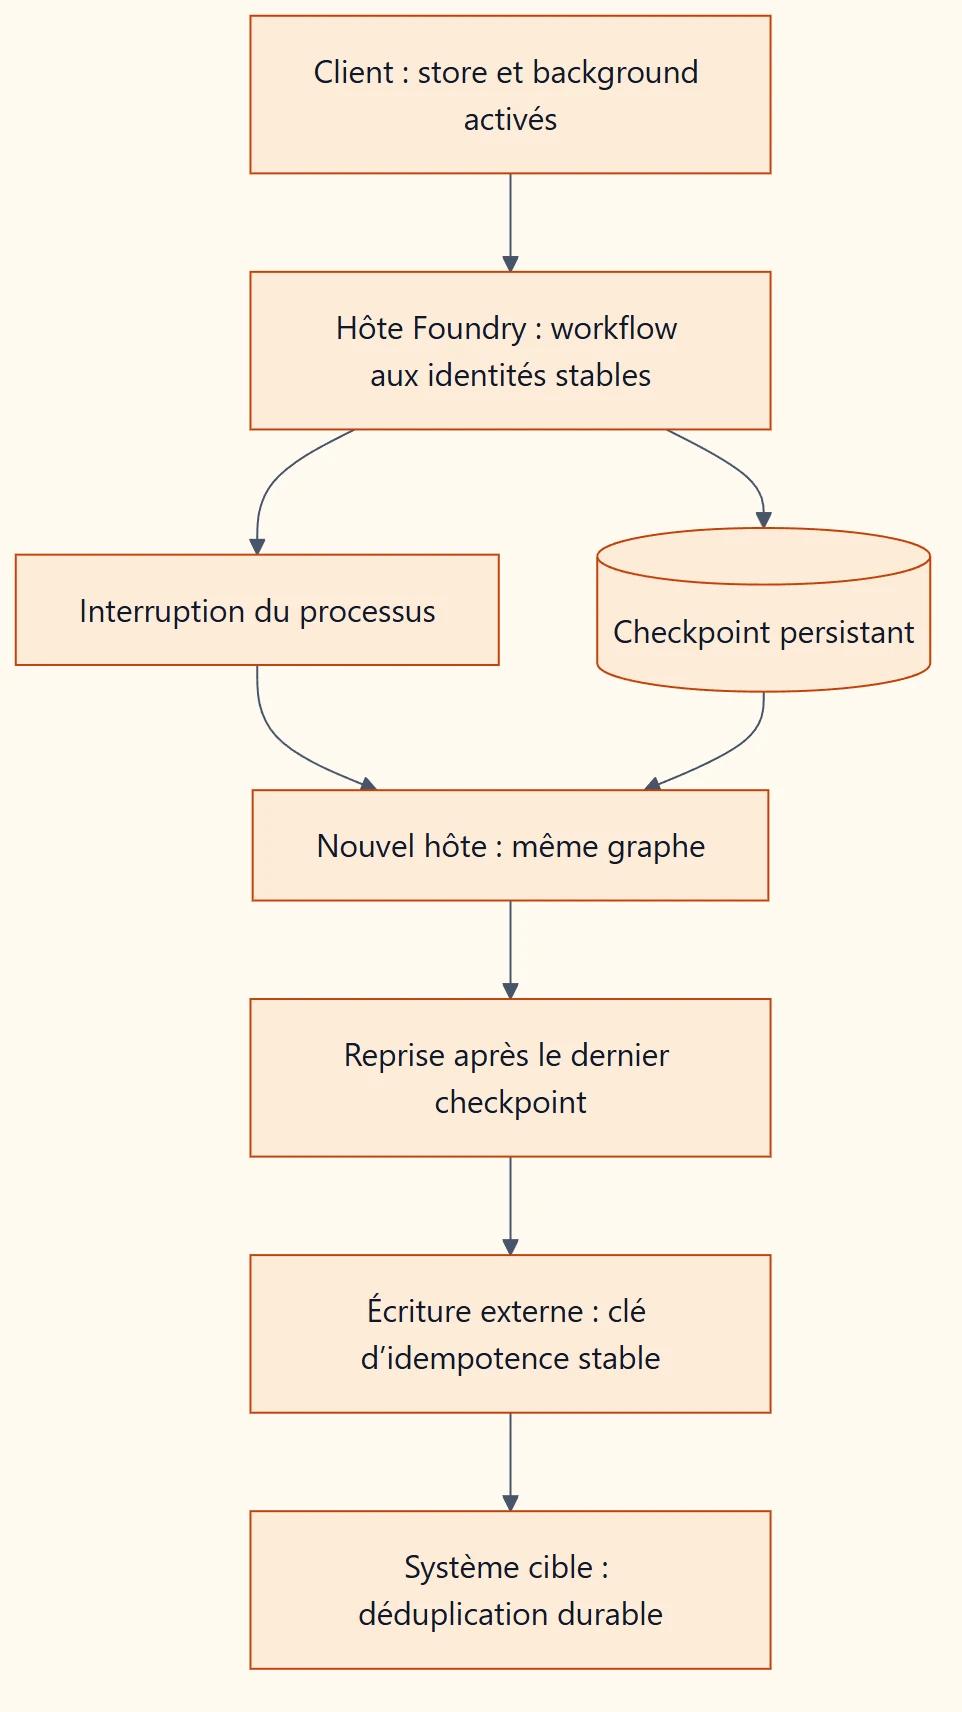
Microsoft Agent Framework a récemment ajouté, dans son intégration Microsoft Foundry, des réponses en arrière-plan résilientes pour les workflows .NET. Avec ResilientBackground, l’hôte associe la réponse asynchrone à des checkpoints persistants et peut reprendre le dernier point durable après un redémarrage. La fonctionnalité est récente : elle ne remplace ni l’idempotence des systèmes externes ni une autorisation métier.
Ce tutoriel construit le squelette d’un agent de compte rendu d’incident. Il publie un endpoint compatible Responses, exécute le workflow en arrière-plan, puis montre comment rendre une action externe rejouable sans doublon. Les tests et la CI vérifient les garanties déterministes ; un vrai modèle n’est nécessaire que pour le test d’intégration isolé.
Ce qui est nouveau, et ce que cela ne résout pas
Une réponse en arrière-plan classique donne surtout un identifiant à interroger. Les réponses en arrière-plan d’un agent .NET expliquent déjà ce modèle de polling. Ici, le sujet est différent : le serveur Foundry conserve l’état nécessaire pour qu’un workflow reprenne après la disparition du processus qui le servait.
| Problème | Réponse résiliente Foundry | Ce qui reste à concevoir |
|---|---|---|
| Le processus redémarre | Reprise depuis le dernier checkpoint de workflow sauvegardé | Noms et identifiants d’exécuteurs stables |
| Le client ne doit pas rester connecté | Réponse background identifiée et consultable | UI de statut et timeout métier |
| Une étape a pu appeler un système externe | Le workflow peut rejouer après la dernière sauvegarde | Clé d’idempotence vérifiée par le système cible |
| Plusieurs personnes utilisent l’agent | Stockage et protocole de réponse isolent les états gérés | Autorisation applicative, isolation tenant et rétention |
La distinction est capitale : un checkpoint est une frontière de progrès du workflow, pas une transaction distribuée. Un arrêt juste après POST /tickets et juste avant la sauvegarde suivante peut conduire à une nouvelle tentative. Chaque écriture externe doit donc porter une clé stable, par exemple workflowRunId + étape, que la cible refuse de traiter deux fois.
Prérequis
Prévoyez :
- le SDK .NET 10 ou une version explicitement supportée par les packages Agent Framework retenus ;
- un projet Microsoft Foundry avec un déploiement de modèle, pour le test de bout en bout ;
- Azure CLI connectée (
az login) et Azure Developer CLI si vous déployez l’exemple ; - PowerShell sous Windows ;
- une identité Foundry à privilèges minimaux, distincte de toute identité de déploiement.
Les packages évoluent rapidement. Commencez avec --prerelease seulement pour découvrir une combinaison qui fonctionne, puis verrouillez les versions validées dans votre dépôt. Dans un projet réel, utilisez aussi un fichier de verrouillage NuGet et faites examiner toute mise à jour comme un changement de plateforme.
dotnet new web --framework net10.0 --name ResilientIncidentAgent
Set-Location ResilientIncidentAgent

dotnet add package Microsoft.Agents.AI
dotnet add package Microsoft.Agents.AI.Workflows
dotnet add package Microsoft.Agents.AI.Foundry.Hosting --prerelease
dotnet add package Azure.AI.Projects
dotnet add package Azure.Identity
dotnet restore --use-lock-file
Le package d’hébergement expose l’adaptateur ASP.NET Core et le protocole Responses. Conservez les paramètres d’accès hors du code et du dépôt :
$env:FOUNDRY_PROJECT_ENDPOINT = "https://<votre-projet>.services.ai.azure.com/api/projects/<projet>"
$env:FOUNDRY_MODEL_DEPLOYMENT = "<deploiement>"
En production, remplacez la chaîne d’identifiants de développement par une identité managée explicitement configurée. Le processus de l’agent ne doit recevoir aucun rôle permettant de modifier une production simplement parce qu’il peut analyser un incident.
1. Définir un workflow dont les identités ne changent pas
Un hôte qui redémarre doit reconstruire le même graphe pour retrouver un checkpoint. Donnez donc un nom stable au workflow et des identifiants stables aux exécuteurs. Ne dérivez jamais ces valeurs d’un utilisateur, d’un ticket ou d’un identifiant de requête.
Créez IncidentWorkflow.cs :
using System.Text.Json;
using Microsoft.Agents.AI.Workflows;
using Microsoft.Extensions.AI;

namespace ResilientIncidentAgent;

public sealed record IncidentInput(string IncidentId, string Summary);
public sealed record IncidentReport(string IncidentId, string Finding);

public sealed class ParseIncidentRequest()
    : ChatProtocolExecutor("parse-incident-request",
        new ChatProtocolExecutorOptions { AutoSendTurnToken = false })
{
    protected override ProtocolBuilder ConfigureProtocol(ProtocolBuilder builder)
        => base.ConfigureProtocol(builder).SendsMessage<IncidentInput>();

    protected override async ValueTask TakeTurnAsync(
        List<ChatMessage> messages,
        IWorkflowContext context,
        bool? emitEvents,
        CancellationToken cancellationToken = default)
    {
        string json = messages.Last(message => message.Role == ChatRole.User).Text;
        IncidentInput input = JsonSerializer.Deserialize<IncidentInput>(
            json, new JsonSerializerOptions(JsonSerializerDefaults.Web))
            ?? throw new ArgumentException("Une entrée JSON est requise.");

        ArgumentException.ThrowIfNullOrWhiteSpace(input.IncidentId);
        ArgumentException.ThrowIfNullOrWhiteSpace(input.Summary);
        await context.SendMessageAsync(input, cancellationToken: cancellationToken);
    }
}

public sealed class AnalyzeIncident()
    : Executor<IncidentInput, ChatMessage>("analyze-incident")
{
    public override ValueTask<ChatMessage> HandleAsync(
        IncidentInput input,
        IWorkflowContext context,
        CancellationToken cancellationToken = default)
    {
        if (string.IsNullOrWhiteSpace(input.IncidentId))
        {
            throw new ArgumentException("L’incident est requis.", nameof(input));
        }

        var report = new IncidentReport(
            input.IncidentId,
            $"Analyse déterministe prête pour {input.IncidentId} : {input.Summary}");

        return ValueTask.FromResult(new ChatMessage(ChatRole.Assistant, report.Finding));
    }
}

public static class IncidentWorkflow
{
    public static Workflow Create()
    {
        var parse = new ParseIncidentRequest();
        var analyze = new AnalyzeIncident();

        return new WorkflowBuilder(parse)
            .AddEdge(parse, analyze)
            .WithOutputFrom(analyze)
            .WithName("incident-recovery-v1")
            .Build();
    }
}
L’exécuteur d’entrée ChatProtocolExecutor accumule les messages et attend le TurnToken du protocole agent, désérialise le dernier message utilisateur JSON avec les noms camelCase et transmet un IncidentInput validé à AnalyzeIncident. Le rapport est converti en ChatMessage assistant, déclaré comme sortie du workflow pour alimenter la réponse agent.
Cet exemple ne fait pas encore appel à un modèle : la première étape reste déterministe afin de rendre le contrat exécutable en CI. Dans une application complète, ajoutez un agent ou un outil après cette étape, en conservant le même nom et les mêmes identifiants lorsque vous déployez une nouvelle instance. Les checkpoints Agent Framework indiquent qu’en .NET l’identité d’un exécuteur dépend notamment de son nom et de son identifiant ; les modifier rend les anciens checkpoints incompatibles.
2. Exposer le workflow dans Foundry avec reprise en arrière-plan
L’extension AsAIAgent() permet de présenter un workflow comme un agent. AddFoundryResponses() branche ensuite le serveur Responses. La configuration de résilience doit être effectuée lors du premier appel à AddFoundryResponses : l’Agent Server y enregistre ses tâches durables.
Remplacez Program.cs par ceci :
using Microsoft.Agents.AI;
using Microsoft.Agents.AI.Foundry.Hosting;
using Microsoft.Agents.AI.Workflows;
using ResilientIncidentAgent;

Workflow workflow = IncidentWorkflow.Create();

AIAgent agent = workflow.AsAIAgent(
    id: "incident-recovery-agent",
    name: "incident-recovery-agent",
    includeWorkflowOutputsInResponse: true);

var builder = WebApplication.CreateBuilder(args);
builder.Services.AddHealthChecks();

builder.Services.AddFoundryResponses(
    agent,
    configure: options => options.ResilientBackground = true);

var app = builder.Build();
app.MapFoundryResponses();
app.MapHealthChecks("/healthz");

await app.RunAsync();
Pour qu’une requête possède un contrat de reprise, elle doit être stockée et exécutée en arrière-plan. L’adaptateur ParseIncidentRequest ci-dessus convertit l’entrée du protocole. Démarrez l’hôte avec dotnet run --urls http://localhost:8088, puis testez depuis un autre terminal :
$body = @{
  input = '{"incidentId":"INC-42","summary":"Les requêtes retournent 503."}'
  store = $true
  background = $true
} | ConvertTo-Json

Invoke-RestMethod -Method Post `
  -Uri "http://localhost:8088/responses" `
  -ContentType "application/json" `
  -Body $body
Conservez l’identifiant response.id retourné par le serveur, puis interrogez son état depuis le client ou l’interface Foundry. Ne fabriquez pas cet identifiant et ne l’interprétez pas comme une autorisation : il sert à retrouver l’opération, pas à prouver l’identité de la personne qui l’observe.
Important : le raccourci
workflow.AsAIAgent()convient au scénario minimal ci-dessus. Pour un workflow qui attend une réponse humaine, traite plusieurs tours ou doit reprendre entre plusieurs processus, suivez le modèle de factory de workflow « native workflow » de la documentation Foundry : elle reconstruit un graphe neuf à chaque requête tout en gardant les identités stables. Cela évite de partager un état mutable en mémoire entre conversations.
3. Rendre une opération externe réellement idempotente
Ne placez jamais un appel de déploiement ou de ticketing directement dans un prompt. Encapsulez-le dans une interface qui reçoit une clé d’idempotence, puis demandez au système cible de mémoriser cette clé avec le résultat de l’opération.
namespace ResilientIncidentAgent;

public interface IChangeGateway
{
    Task<string> CreateTicketAsync(
        string idempotencyKey,
        IncidentReport report,
        CancellationToken cancellationToken);
}

public sealed class CreateIncidentTicket(IChangeGateway gateway)
{
    public Task<string> ExecuteAsync(
        string workflowRunId,
        IncidentReport report,
        CancellationToken cancellationToken)
    {
        if (string.IsNullOrWhiteSpace(workflowRunId))
        {
            throw new ArgumentException("Le run est requis.", nameof(workflowRunId));
        }

        string key = $"incident-ticket:{workflowRunId}:v1";
        return gateway.CreateTicketAsync(key, report, cancellationToken);
    }
}
La valeur v1 est volontaire : changez-la seulement si l’opération métier doit réellement devenir une nouvelle commande. Côté IChangeGateway, utilisez une contrainte d’unicité ou le mécanisme d’idempotence de l’API cible. Un HashSet en mémoire ne suffit pas, car il disparaît précisément lors du redémarrage qui déclenche la reprise.
Évitez aussi de sauver un checkpoint après une action en supposant que cela la rend atomique. La fenêtre entre l’effet de bord et l’écriture du checkpoint existe toujours. La bonne combinaison est : checkpoint fréquent + clé d’idempotence durable + opération réversible ou compensable lorsque c’est possible.
4. Tester les garanties sans modèle ni cloud
Les tests de pull request doivent vérifier les règles qui ne dépendent pas d’un fournisseur. Ajoutez un projet xUnit, référencez l’application, puis testez l’entrée et la clé d’idempotence avec un faux gateway :
dotnet new xunit --framework net10.0 --output ../ResilientIncidentAgent.Tests
dotnet add ../ResilientIncidentAgent.Tests reference .
dotnet restore ../ResilientIncidentAgent.Tests/ResilientIncidentAgent.Tests.csproj --use-lock-file
Le projet de tests est voisin du projet web pour éviter que les globs C# de l’application compilent les fichiers xUnit. Versionnez les deux fichiers packages.lock.json. La CI ci-dessous suppose que le dépôt contient ces deux dossiers à sa racine.
using Microsoft.Agents.AI;
using Microsoft.Agents.AI.Workflows;
using ResilientIncidentAgent;

namespace ResilientIncidentAgent.Tests;

public sealed class CreateIncidentTicketTests
{
    [Fact]
    public async Task Routes_the_request_json_through_the_agent()
    {
        AIAgent agent = IncidentWorkflow.Create().AsAIAgent(
            includeWorkflowOutputsInResponse: true);

        AgentResponse response = await agent.RunAsync(
            """{"incidentId":"INC-42","summary":"Les requêtes retournent 503."}""");

        Assert.Contains("INC-42", response.Text);
        Assert.Contains("503", response.Text);
    }

    [Fact]
    public async Task Reuses_the_same_key_when_a_step_is_replayed()
    {
        var gateway = new RecordingGateway();
        var action = new CreateIncidentTicket(gateway);
        var report = new IncidentReport("INC-42", "Les sondes échouent.");

        await action.ExecuteAsync("run-123", report, CancellationToken.None);
        await action.ExecuteAsync("run-123", report, CancellationToken.None);

        Assert.Equal(
            ["incident-ticket:run-123:v1", "incident-ticket:run-123:v1"],
            gateway.Keys);
    }

    private sealed class RecordingGateway : IChangeGateway
    {
        public List<string> Keys { get; } = [];

        public Task<string> CreateTicketAsync(
            string idempotencyKey,
            IncidentReport report,
            CancellationToken cancellationToken)
        {
            Keys.Add(idempotencyKey);
            return Task.FromResult("TICKET-99");
        }
    }
}
Ce test ne prouve pas que le système tiers déduplique : il prouve que le workflow lui envoie une clé stable lorsqu’une étape est rejouée. Ajoutez ensuite un test d’intégration contre un environnement synthétique qui vérifie qu’une seconde requête avec la même clé retourne le même résultat, sans créer une seconde ressource.
5. Tester une reprise contrôlée avant la production
Dans un environnement de test Foundry, lancez une demande store: true et background: true, puis interrompez intentionnellement le processus après un checkpoint connu. Redémarrez l’hôte avec le même déploiement et observez la même response.id jusqu’à sa conclusion. Les contrôles importants sont :
- les éléments déjà produits n’apparaissent ni manquants ni dupliqués ;
- l’étape redémarre à la frontière de checkpoint attendue ;
- une écriture externe conserve le même résultat grâce à sa clé d’idempotence ;
- un nouveau déploiement conserve le nom du workflow et les identifiants des exécuteurs ;
- un client non autorisé ne peut pas consulter ou poursuivre la réponse d’un autre utilisateur.
Les décisions d’architecture du projet Agent Framework décrivent aussi les essais de reprise : interruption forcée, restauration de session et vérification qu’un décompte final ne comporte aucune valeur manquante ou répétée. Reprenez le principe avec un effet de bord synthétique avant de connecter Jira, GitHub ou une plateforme de déploiement.
6. Séparer la CI déterministe du test d’intégration privilégié
Une pull request ne devrait jamais obtenir une identité capable d’écrire dans Foundry ou dans un outil de production. Utilisez deux niveaux :
name: Validate resilient workflow

on:
  pull_request:
  push:
    branches: [main]

permissions:
  contents: read

jobs:
  unit:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-dotnet@v4
        with:
          dotnet-version: 10.0.x
      - run: dotnet restore ResilientIncidentAgent.Tests/ResilientIncidentAgent.Tests.csproj --locked-mode
      - run: dotnet test ResilientIncidentAgent.Tests/ResilientIncidentAgent.Tests.csproj --no-restore --configuration Release

  recovery-integration:
    if: github.event_name == 'push'
    needs: unit
    environment: agent-integration
    permissions:
      contents: read
      id-token: write
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: azure/login@v2
        with:
          client-id: ${{ secrets.AZURE_CLIENT_ID }}
          tenant-id: ${{ secrets.AZURE_TENANT_ID }}
          subscription-id: ${{ secrets.AZURE_SUBSCRIPTION_ID }}
      - run: ./scripts/test-recovery.ps1
        shell: pwsh
Le premier job compile et exécute les règles pures. Le second doit cibler un projet Foundry isolé, créer seulement des données de test et détruire ou expirer ces données selon une politique connue. La fédération OIDC évite de conserver un secret client longue durée dans GitHub Actions ; elle ne dispense pas de restreindre les rôles au dépôt, à la branche et à l’environnement attendu.
Points de vigilance
backgroundsansstoren’a pas de contrat de reprise. Envoyez explicitement les deux valeurs et testez-les dans le client réel.- Le premier enregistrement décide de la résilience. Configurez
ResilientBackgroundlors du premierAddFoundryResponses, avant qu’un autre module n’enregistre un serveur Responses. - Les checkoints ne sont pas compatibles par magie. Versionnez vos changements de graphe et démarrez une nouvelle lignée pour une migration qui renomme une étape.
- Une reprise n’est pas exactement une fois. Limitez les effets de bord, conservez une clé idempotente durable et prévoyez une compensation.
- Les sessions et checkpoints peuvent contenir des données sensibles. Définissez une rétention, des contrôles d’accès, une redaction des traces et un nettoyage des environnements de test.
- Les réponses passées restent non fiables. Une sortie de modèle ou un commentaire d’incident ne doit jamais devenir une URL, une commande ou un paramètre de déploiement sans validation typée et liste blanche côté serveur.
Sources
- Microsoft détaille les expériences interactives, la mémoire et l’exécution résiliente, avec le branchement .NET
AddFoundryResponsesetResilientBackground. - La documentation Foundry Hosted Agents précise les conditions
store/background, le rôle des checkpoints et les limites de la reprise sur les effets de bord. - Le code source de
FoundryResponsesOptionsexplique pourquoi l’option doit être activée au premier enregistrement du serveur. - Le guide Checkpointing dans Microsoft Agent Framework documente l’importance des identités stables pour retrouver les checkpoints.
- Microsoft Foundry propose un parcours de test d’agent résilient : provoquer un arrêt, redémarrer et constater la reprise depuis le dernier checkpoint.
Une réponse longue n’est opérationnelle que si son redémarrage est prévu avant l’incident. Les réponses résilientes Foundry réduisent la perte de progrès ; des identités de workflow stables, des tests de redémarrage et l’idempotence des effets de bord empêchent que cette reprise ne crée un nouveau problème.